Başlarken
Kurulum
bitig Python 3.11+ gerektirir.
İsteğe bağlı eklentiler
uv pip install "bitig[cluster]"     # reduce/cluster için UMAP + HDBSCAN
uv pip install "bitig[bayesian]"    # hiyerarşik modeller için PyMC + arviz
uv pip install "bitig[embeddings]"  # sentence-transformers + bağlamsal BERT
uv pip install "bitig[viz]"         # plotly, kaleido, ete3
uv pip install "bitig[reports]"     # PDF rapor dışa aktarımı için weasyprint
uv pip install "bitig[gui]"         # `bitig gui` için NiceGUI + pywebview
uv pip install "bitig[turkish]"     # Türkçe için Stanza arka ucu
uv pip install "bitig[docs]"        # mkdocs + material teması (bu siteyi derlemek için)
spaCy modeli yalnızca bitig ingest ve Python API'sindeki ayrıştırmaya dayalı öznitelikler
için gereklidir; bitig run ham metin üzerinde çalışır.
İngilizce okunabilirlik ölçütleri CMU sesletim sözlüğünü gerektirir ve bitig bu sözlüğü hiçbir
zaman kendiliğinden indirmez. Sözlüğü bir kez python -m nltk.downloader cmudict ile kurun;
sözlük yoksa okunabilirlik çıkarıcısı bu komutu belirten bir hata verir.
Beş komutla bir çalışma
bitig init my-study          # (1) bir proje dizini oluşturun
cd my-study
# (2) .txt dosyalarını corpus/ içine bırakın ve corpus/metadata.tsv ekleyin
#     (sekmeyle ayrılmış: bir filename sütunu ve author, group, year, ...)
# (3) study.yaml içinde `metadata: corpus/metadata.tsv` satırının yorumunu kaldırın
bitig info                         # (4) sürümleri ve yapılandırılmış dili denetleyin
bitig run study.yaml --name demo   # (5) bildirilen çalışmayı çalıştırın
bitig report results/demo --output results/demo/report.html
bitig init; corpus/, results/, reports/, .bitig/cache/, bir .gitignore, kısa bir
README.md ve author üst veri sütununa göre gruplanmış 1000 en sık sözcük üzerinde Burrows
Delta çalıştıran bir study.yaml oluşturur. metadata.tsv oluşturmaz; Delta, author
sütunu içeren bir üst veri dosyası gerektirir. bitig info; bitig, Python, platform ve spaCy
sürümlerini ve bir proje içinde çalıştırıldığında study.yaml dosyasında ayarlı dili
yazdırır. study.yaml dosyasına başka yöntemler eklemek için
şema başvurusuna bakın.
bitig run, herhangi bir yöntem başarısız olursa başarısız yöntemleri listeleyerek 1 çıkış
koduyla sonlanır (her yöntemin error.txt dosyası hata izini içerir). Ayrıca --overwrite
verilmedikçe önceki bir çalıştırmanın çıktılarını barındıran bir çalıştırma dizinine yazmayı
reddeder.
İlk Python oturumunuz
.txt dosyalarından oluşan bir corpus/ klasörü ve bir corpus/metadata.tsv içeren bir
dizinden çalıştırın (örneğin tartışmalı makalenin Unknown olarak etiketlendiği
examples/quickstart/
klasörünün bir kopyası):
from pathlib import Path

import numpy as np

from bitig import BurrowsDelta, MFWExtractor, PCAReducer, load_corpus, plot_scatter_2d

# corpus/ altındaki her .txt dosyasını üst veri satırıyla birlikte yükleyin (filename → author, role, ...).
corpus = load_corpus(Path("corpus"), metadata=Path("corpus/metadata.tsv"))

# 1. En sık sözcük öznitelik matrisini çıkarın.
fm = MFWExtractor(n=200, scale="zscore", lowercase=True).fit_transform(corpus)

# 2. Burrows Delta'yı bilinen belgeler üzerinde eğitin ve sorgulanan belgeyi atfedin.
authors = np.array(corpus.metadata_column("author"))
known = authors != "Unknown"
delta = BurrowsDelta().fit(fm.X[known], authors[known])
questioned = [d for d, k in zip(fm.document_ids, known) if not k]
print(dict(zip(questioned, delta.predict(fm.X[~known]).tolist())))
# {'fed_50': 'Madison'}

# 3. PCA ile iki boyuta indirgeyin ve çizdirin.
pca = PCAReducer(n_components=2).fit_transform(fm)
fig = plot_scatter_2d(pca.values["coordinates"], labels=fm.document_ids, groups=list(authors))
fig.savefig("pca.png")
Örnek veri: Federalist örneği
Depo ile birlikte çalıştırmaya hazır iki örnek gelir:
examples/quickstart/— tartışmalı 50. makale dahil 9 makale kullanan başlangıç dostu bir kılavuz.examples/federalist/— Mosteller & Wallace (1964) sonucunu yeniden üreten 85 makalenin tam analizi.
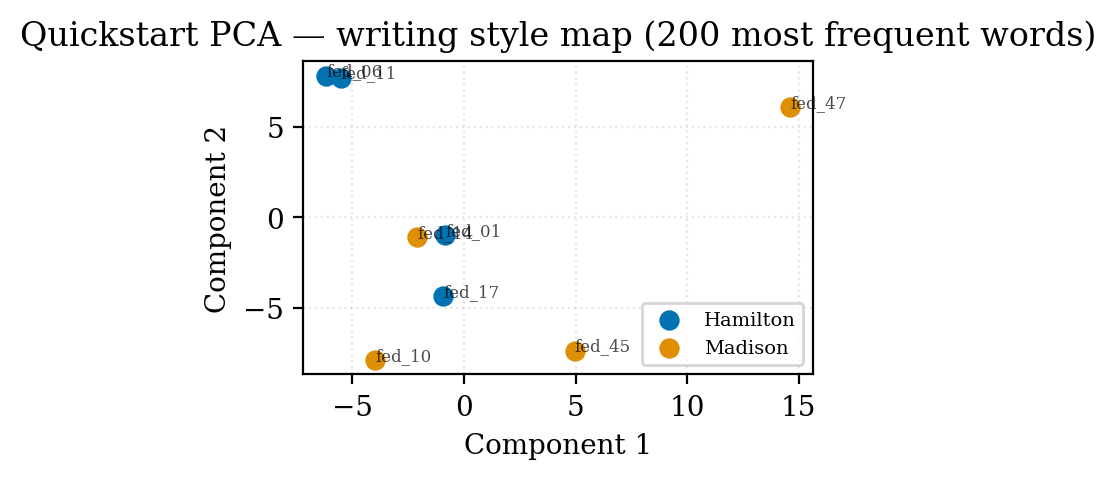
Hızlı başlangıç çalışması, sekiz eğitim makalesinin şu PCA grafiğini yazar (50. makale
role: [train] filtresiyle dışarıda tutulur ve ayrıca
bitig delta ... --test-filter role=test ile atfedilir):
Sonraki adımlar
- Ortak zihinsel modeli Kavramlar bölümünde öğrenin.
- Doğrulama, LR çıktısı ve PAN tarzı değerlendirme için Adli dilbilim araç takımına geçin.
- Mosteller & Wallace'ı Federalist öğreticisinde yeniden üretin.